Few-Shot Learning
Few-Shot Learning
—— 从直觉、原理到真实应用场景,一次彻底搞懂
一、为什么“少样本学习”如此重要?
传统深度学习的一个核心前提是:
大量、干净、标注准确的数据
但现实世界恰恰相反:
- 新类别不断出现
- 冷启动问题普遍存在
- 标注成本高(医疗、法律、工业)
- 长尾类别样本极少
于是一个关键问题出现了:
模型能不能像人一样,只看很少的例子,甚至不看例子,就学会新概念?
这正是 Zero-Shot / One-Shot / Few-Shot Learning 要解决的问题。
二、从“人类学习”直觉理解三种范式
在进入技术细节前,我们先用人类认知类比:
- 你从未见过“袋獾”,但听过描述 → Zero-Shot
- 你只见过一次某个人 → One-Shot
- 你见过几次某种新工具 → Few-Shot
模型学习方式,正在向这种 “低样本泛化能力” 靠拢。
三、Zero-Shot Learning(零样本学习)
1. 定义
Zero-Shot Learning(ZSL) 指的是:
模型在 训练阶段从未见过某个类别的任何样本, 但在测试阶段,仍然能够正确识别该类别。
2. Zero-Shot 的核心思想
Zero-Shot 并不是“瞎猜”,而是:
借助“语义桥梁”完成跨类别泛化
这个桥梁通常是:
- 类别的 文本描述
- 属性标签(Attributes)
- 语言嵌入(Text Embedding)
- 语义空间(Semantic Space)
3. 一个经典直观例子
假设模型学过这些动物:
- 马
- 虎
- 狗
但从未学过:斑马
然而你告诉模型:
斑马 = 像马 + 有黑白条纹
模型就可以在 语义空间中组合已有知识,识别斑马。

4. Zero-Shot 的技术本质
从数学/建模角度看,ZSL 通常做的是:
- 将 输入样本 映射到一个向量空间
- 将 类别描述 也映射到同一空间
- 通过相似度(cosine / dot product)完成匹配
模型学的是“语义对齐”,而不是具体类别
5. 典型应用
- 新商品自动分类
- 跨语言 / 跨领域 NLP
- 图像-文本联合模型(如 CLIP)
- 大模型 Prompt Zero-Shot 推理
四、One-Shot Learning(一次样本学习)
1. 定义
One-Shot Learning 指:
每个类别 只有 1 个已知样本, 模型需要据此完成识别或分类。
2. 为什么 One-Shot 很难?
传统分类模型的问题在于:
- 分类器参数 ≈ 类别数量
- 一个样本根本不足以拟合分布
- 极易过拟合
所以 One-Shot 的关键不在“分类”,而在:
比较(Comparison)
3. One-Shot 的核心策略:度量学习
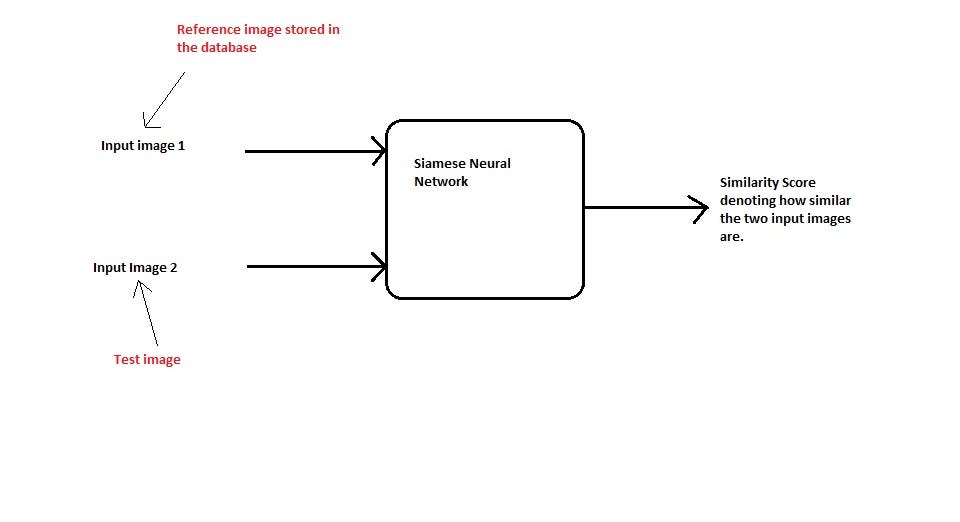
模型不直接输出类别,而是回答:
“这两个样本像不像?”
经典结构是 Siamese Network(孪生网络):
4. 工作流程(非常重要)
- 使用大量 已有类别 训练模型
- 学习一个 通用嵌入空间
- 新类别只需 1 个样本
- 测试时用“距离最近”来判断类别
✔ 学到的是“相似性规则”,不是类别本身
5. 经典应用
- 人脸识别(每人仅一张照片)
- 签名识别
- 身份验证
- 工业缺陷对比检测
五、Few-Shot Learning(少样本学习)
1. 定义
Few-Shot Learning(FSL) 指:
每个类别只有 少量样本(通常 2–10) 仍然需要模型具备良好泛化能力
2. 常见任务形式(论文中必见)
N-way K-shot
- N:类别数
- K:每类样本数
例如:
- 5-way 1-shot
- 5-way 5-shot
3. Few-Shot 的核心思想
Few-Shot ≠ 训练一个小模型 而是:
在“任务层面”学习泛化能力
这催生了一个重要方向:
Meta-Learning(元学习)
4. 元学习一句话解释
不是学“怎么分类”,而是学“怎么快速学会分类”
典型方法:
- MAML
- Prototypical Networks
- Matching Networks
5. 原型网络(非常直观)
- 每个类别 → 一个“原型向量”
- 原型 = 类内样本均值
- 分类 = 找最近的原型
六、三种方法的系统对比(进阶理解)
| 维度 | Zero-Shot | One-Shot | Few-Shot |
|---|---|---|---|
| 是否见过该类 | 否 | 是 | 是 |
| 样本数量 | 0 | 1 | 2–10 |
| 核心能力 | 语义迁移 | 相似度比较 | 快速泛化 |
| 常用技术 | 语义嵌入 | 度量学习 | 元学习 |
| 难度 | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐ |
七、与大模型(LLM)的关系
你可能已经用过:
“把下面的文本分类成情感类别”这本质上是 Zero-Shot NLP。
Few-Shot Prompt:
示例1:……
示例2:……
现在请判断……
本质就是 Few-Shot Learning 的 Prompt 版本。
八、总结(适合博客结尾)
- Zero-Shot:没有样本,但有语义
- One-Shot:只有一个样本,靠比较
- Few-Shot:少量样本,靠快速泛化
它们共同的目标是:
让模型在“数据不完美的真实世界”中依然可用
这正是现代 AI 从“实验室模型”走向“真实产品”的关键一步。