CNN
大约 4 分钟
CNN
一、一句话先说明白:CNN 到底是啥?
CNN(卷积神经网络)就是一台“会自己学会看图的机器”。
- 人看图片:先看轮廓,再看形状,最后判断是什么
- CNN 看图片:一层一层学特征,最后给出结论
二、先讲最关键的:机器是怎么“看图片”的?
1. 图片在电脑里其实不是“照片”
在电脑里,一张图片本质上是 一堆数字:
- 黑色 ≈ 0
- 白色 ≈ 255
- 彩色 = 红绿蓝三组数字
例如一小块图片可能是这样:
120 125 130
118 122 128
110 115 120
CNN 不看“猫”“人”“车”,它只看这些数字。
三、CNN 的第一步:学会“看局部”
人看东西不是一眼看全图,而是先看局部。
CNN 也是一样。
CNN 用的工具叫:卷积核(小窗口)
你可以把它理解成:
“一个 3×3 的小放大镜,在图片上慢慢滑动”

这个小窗口会做三件事:
- 覆盖图片的一小块
- 和图片里的数字做计算
- 得到一个新数字
四、卷积到底在算什么?(极度白话版)
你可以这样理解:
卷积 = 检查这一小块像不像某种特征
比如这个小窗口可以专门用来检查:
- 是不是一条“横线”
- 是不是一条“竖线”
- 是不是一个拐角
如果很像 → 给高分 如果不像 → 给低分
五、第一层卷积:只学最简单的东西
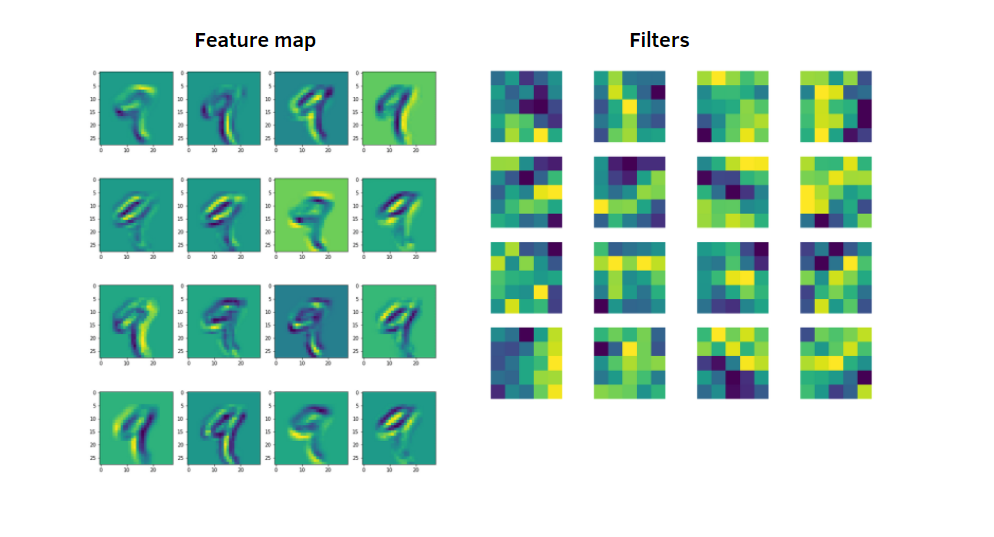
CNN 的第一层通常学的是:
- 边缘
- 线条
- 明暗变化


你可以理解为:
“这一层只负责:哪里有线条?”
六、第二层卷积:开始学“形状”
第二层不再看原图,而是看 第一层的结果。
它学的东西更复杂:
- 圆形
- 角
- 简单结构


这就像:
- 第一层:学会画“笔画”
- 第二层:学会认“字的一部分”
七、越往后,越“聪明”
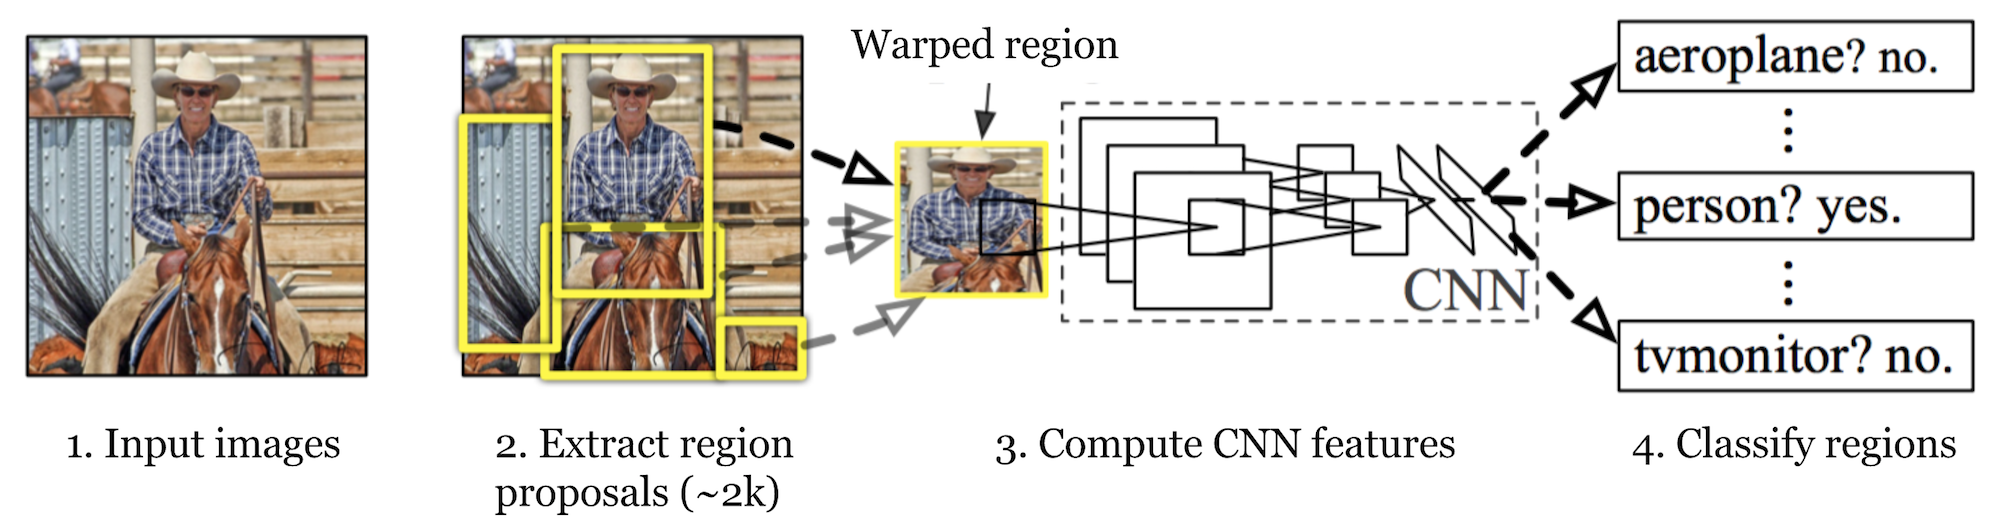
再往后的层,CNN 能学到:
- 猫的耳朵
- 车轮
- 人脸轮廓


⚠️ 重点来了:
这些特征不是人教的,是 CNN 自己“试错学会的”
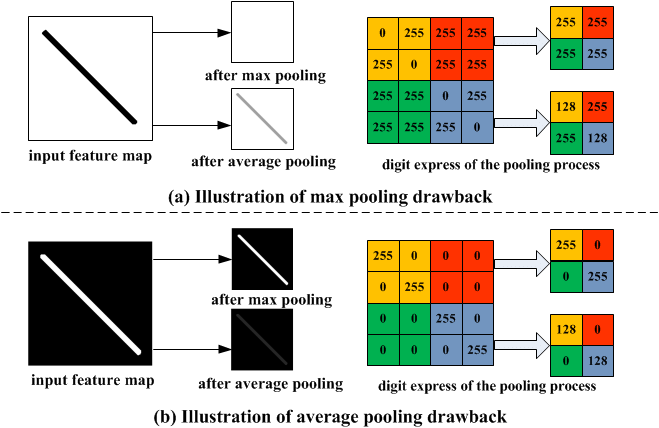
八、为什么中间要“压缩”?(池化层)
CNN 学的特征越来越多,图片也越来越大,怎么办?
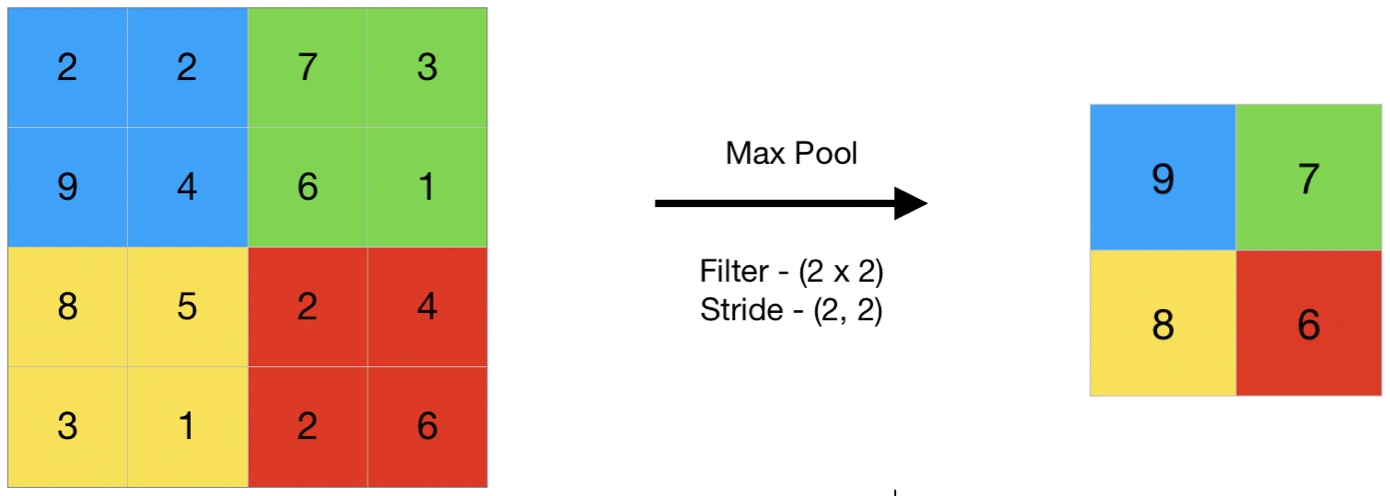
我们会用池化(Pooling)。
池化是干嘛的?
一句话:
保留重点,丢掉细节
比如:
2 5
1 3最大池化后只留下:5
好处:
- 图片变小
- 计算更快
- 不容易被噪声干扰
九、到这里,CNN 已经“看懂图片”了
经过多层卷积 + 池化之后:
- 图片已经不是“像素”
- 而是 一堆高级特征
此时 CNN 知道:
- “这里像耳朵”
- “那里像轮子”
- “这个结构像猫”
十、最后一步:做选择(全连接层)
现在问题来了:
这些特征到底代表什么?
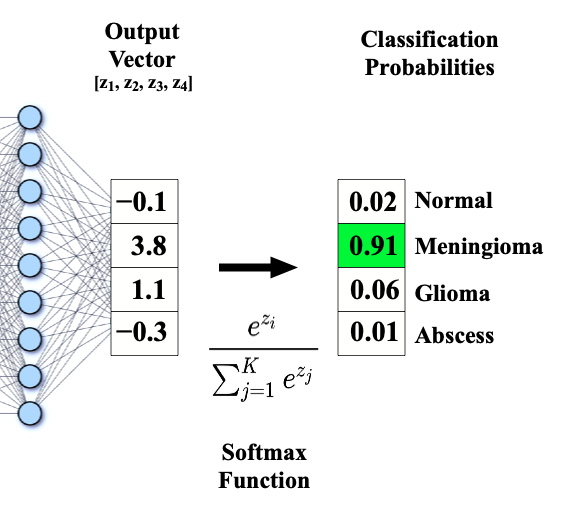
于是 CNN 用 全连接层 来做判断。
你可以把它想成:
“考试打分系统”
- 猫:92 分
- 狗:6 分
- 汽车:2 分
分数最高的,就是答案。


十一、CNN 是怎么学会的?(训练过程)
1. 给它一张图
“这是猫”
2. CNN 猜
“我觉得是狗”
3. 告诉它错了
“你错了,扣分”
4. 它自动调整参数
下次猜得更准
这一步重复 成千上万次。
十二、为什么 CNN 这么厉害?
| 原因 | 说明 |
|---|---|
| 自动学特征 | 不用人工写规则 |
| 只看局部 | 更像人眼 |
| 参数共享 | 不容易爆炸 |
| 层次理解 | 从简单到复杂 |
十三、CNN 能用来干什么?
- 人脸识别
- 医学影像
- 自动驾驶
- 安防监控
- OCR 文字识别
- 视频分析
只要是“看图”的活,CNN 都能干。
十四、一句终极总结(给奶奶版)
CNN 就是一台会自己学习“怎么看图”的机器
它先学线条,再学形状,最后学整体
看得多了,自然就认识猫、狗、车、人